[아이뉴스24 서효빈 기자] 서울대학교 연구진이 국내외 인공지능(AI) 모델의 한국어 능력을 평가한 결과 해외 AI가 모든 평가 영역에서 높은 성적을 기록했다. 국내 AI는 평가 영역에 따라 서로 다른 강점을 보였다.
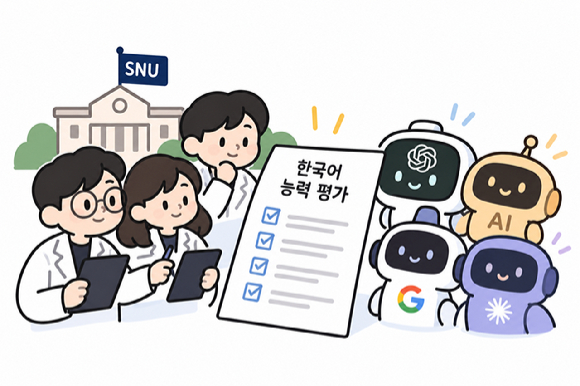
20일 논문 사전공개 사이트 '아카이브(arXiv)'에 따르면 서울대 데이터사이언스대학원과 컴퓨터공학부 연구진은 '한국어 파운데이션 모델 평가를 위한 벤치마크 모음(KBS)' 논문에서 국내외 AI 모델을 대상으로 총 9396개 문항을 활용해 한국어 성능을 평가했다.
평가 영역은 과학 문제 해결, 수학 추론, 감정 이해, 상식·문맥 추론, 문학 문맥 이해, 지시 수행 등 6개다. 과학 문제는 기초와 고난도로 나눠 총 7개 세부 영역에서 성능을 비교했다.
국내에서는 SK텔레콤 'A.X 4.0', KT '믿:음 2.0', LG AI연구원 '엑사원 4.0', 네이버 '하이퍼클로바X', 카카오 '카나나2' 등 5개 모델 계열이 평가 대상에 포함됐다. 해외에서는 오픈AI 'GPT-5.5', 앤트로픽 '클로드 오푸스 4.7', 구글 '젬마4', 알리바바 '큐웬3.5' 등을 평가했다.
◇해외 AI, 7개 영역 석권…클로드 4개·GPT 2개 1위
평가 결과 해외 AI 모델이 7개 세부 영역 모두에서 국내 AI보다 높은 최고 점수를 기록했다.
앤트로픽 '클로드 오푸스 4.7'은 과학 기초 문제에서 99.12%의 정답률을 기록했다. 상식·문맥 추론에서는 93.37%, 문학 문맥 이해에서는 98.76%로 가장 높은 성적을 거뒀다. 감정 이해에서도 79.23점으로 전체 평가 모델 가운데 1위를 차지했다.
오픈AI 'GPT-5.5'는 과학 고난도 문제에서 97.77%, 수학 추론에서 96.29%의 정답률을 기록해 각각 최고 성적을 거뒀다.
지시 수행 영역에서는 구글 '젬마4 31B-it'가 85.02%로 가장 높은 점수를 기록했다. GPT-5.5는 81.09%, 클로드 오푸스 4.7은 79.55%였다.
국내 AI와 해외 AI 간 격차는 평가 영역에 따라 달랐다. 과학 기초 문제에서 해외 최고 모델과 국내 최고 모델의 정답률 차이는 3.71%포인트였지만 상식·문맥 추론에서는 23.60%포인트까지 벌어졌다.
◇국내 AI끼리 평가서는 성적 엇갈려…카카오 3개·LG 2개 영역 선두
국내 AI 모델만 보면 평가 영역에 따라 결과가 달랐다. 카카오 '카나나2'는 과학 기초 문제에서 95.41%, 고난도 문제에서 88.52%를 기록해 국내 모델 가운데 가장 높은 정답률을 보였다. 지시 수행 평가에서도 76.58%로 국내 1위를 차지했다.
LG '엑사원 4.0 32B'는 상식·문맥 추론에서 69.77%로 국내 최고 성적을 거뒀다. 감정 이해 평가에서도 61.06점으로 국내 모델 가운데 가장 높은 점수를 기록했다.
문학 문맥 이해에서는 KT '믿:음 2.0 Base'가 86.65%로 국내 모델 중 1위를 차지했다. 수학 추론에서는 SK텔레콤 'A.X 4.0 Light'가 82.18%로 국내 최고 성적을 기록했다.
연구진은 국내외 모델을 동일한 기준으로 비교하기 위해 AI가 직접 정답을 생성하는 방식을 활용했다. 과학·상식·문학 영역에서는 제시된 선택지 가운데 정답을 출력하도록 했고 수학·감정 이해·지시 수행 영역에서는 과제별 정답과 지시사항 준수 여부 등을 평가했다.
/서효빈 기자([email protected])
--comment--
첫 번째 댓글을 작성해 보세요.
댓글 바로가기