[아이뉴스24 최효경 기자] 김장우 망고부스트 대표는 "망고부스트는 네오클라우드 회사를 넘어선 AI 팩토리 회사로, 전세계에서 유일하게 독자 설계한 하드웨어를 기반으로 서비스까지 바로 연결할 수 있는 기업"이라며 "이제 고객에게 바로 가는 서비스를 시작한다"라고 말했다.
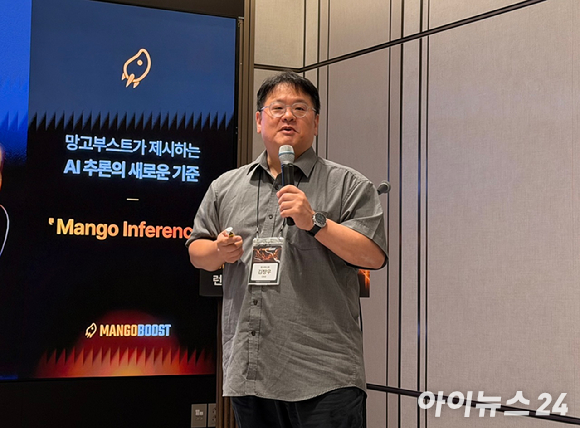
김장우 대표는 12일 서울에서 열린 신규 서비스 출시 간담회에서 이같이 말했다. 그래픽서버장치(GPU) 서버를 구매해 가상화한 뒤 빌려주는 네오클라우드와 달리, 망고부스트는 직접 설계한 하드웨어와 소프트웨어를 묶어 직접 인공지능(AI) 서비스를 제공하는 것을 지향한다.
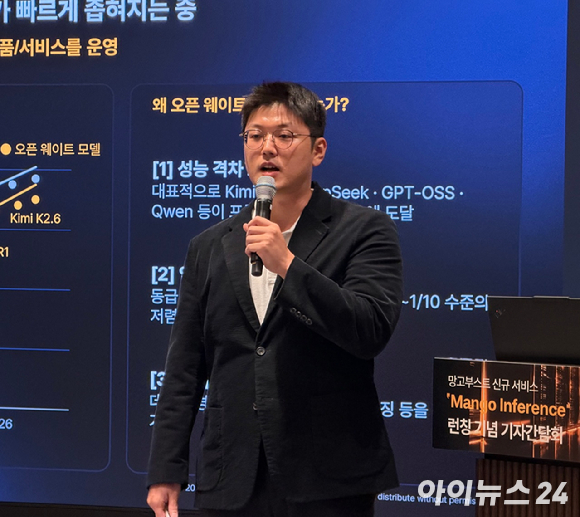
그 첫번째 상품이 이날 공개한 '망고 인퍼런스'다. 권동업 망고부스트 최고기술책임자(CTO)는 "망고 인퍼런스는 기업이나 개발자가 GPU 클러스터를 직접 구축·운영하지 않고도 공개형(오픈웨이트) 거대언어모델(LLM)을 응용프로그램 인터페이스(API)로 연결해 쓸 수 있게 한 AI 추론 서비스"라고 설명했다.
망고 인퍼런스는 문맥 데이터를 나눠 관리하는 방식으로 효율성을 높였다는 게 권 COT의 설명이다. 그는 "긴 문맥을 처리할 때 GPU 메모리와 서버 자원에만 의존하면 성능이나 비용 측면에서 비효율이 발생할 수밖에 없다"며 "LLM부스트(Boost)가 GPU 유휴 시간을 줄이고, 데이터처리장치(DPU)와 스토리지가 길어진 문맥 데이터를 나눠 관리함으로써, 같은 장비로 더 많은 요청을 처리할 수 있다"고 강조했다.
GPU를 빌려주는 대신, 모델 운영을 맡는다
핵심은 단순히 GPU를 빌려주는 서비스가 아니라, 기업이 AI 모델을 실제 서비스에 붙이고 운영하는 과정을 대신하는 것이다.
권 CTO는 "오픈웨이트 모델을 망고부스트 자체 인프라에 탑재해 API 형태로 제공하는 것"이라며 "개발자는 망고 인퍼런스에서 API 키를 발급받아 기존 애플리케이션이나 AI 에이전트에 연결하면 된다"고 말했다.
망고부스트는 모델별 추론 엔진 최적화, GPU 자원 배분, 요청량 변화에 따른 서버 운영을 담당한다. 권 CTO는 "지난 한 달간 한국·일본·미국·싱가포르에서 테스트를 거친 뒤 이날 정식 유료 서비스를 시작했다"고 설명했다.
"LLM부스트로 추론 경로 최적화⋯긴 문맥 데이터 효율적 관리"
망고부스트가 GPU 자체보다 LLM부스트(Boost)와 데이터처리장치(DPU), 스토리지를 함께 강조한 이유는 AI 에이전트의 작동 방식과 맞닿아 있다. AI 에이전트는 한 번의 질문에 답하는 챗봇과 달리 이전 대화, 사내 문서, 도구 호출 결과를 반복해 읽으며 일을 수행한다. 이 과정에서 모델이 이미 읽은 내용을 기억하는 'KV 캐시(단기기억)'가 계속 커진다.
문맥이 길어질수록 이를 GPU 메모리에만 쌓아두는 방식은 속도와 비용 모두에 부담이 된다. 망고부스트는 LLMBoost로 추론 경로를 최적화하고, DPU가 캐시 압축과 데이터 이동·라우팅을 맡도록 설계했다. 여기에 분산형 스토리지를 연동해 긴 문맥 데이터를 더 효율적으로 관리하겠다는 전략이다.
권 CTO는 "동일한 AMD MI355X GPU에서 LLMBoost를 적용한 GLM-5.3은 오픈소스 추론 엔진인 SGLang·vLLM 대비 처리량이 2.8배 높고, 지연시간은 4.3배 짧았다"며 "DeepSeek-V4-Pro에서도 처리량 2.6배, 지연시간 3.5배 개선 효과가 있었다"고 언급했다.
GLM-5.3과 DeepSeek-V4-Pro는 기업이 서비스에 붙여 쓸 수 있는 공개형 거대언어모델(LLM)이다. MI355X는 이 모델을 돌리는 미국 반도체 기업 AMD의 AI용 GPU다. SGLang·vLLM은 모델을 GPU에서 운영할 때 널리 쓰이는 오픈소스 추론 엔진이며, LLMBoost는 망고부스트 자체 소프트웨어다.
망고부스트는 서비스의 기반이 될 데이터센터 전략도 함께 제시했다. 권 CTO는 "내년 1분기 강남에 1메가와트(MW) 규모 '에이전트 팩토리'를 완공할 계획"이라고 말했다. GPU와 DPU, 스토리지를 자체 설계대로 묶어 운영하는 AI 데이터센터로, 이 인프라가 갖춰지면 추론 성능과 원가 구조를 더 끌어올리고 국내에서 AI 데이터를 처리·관리하는 기반도 마련할 수 있다는 설명이다.
현재 망고 인퍼런스는 망고부스트 보유 인프라와 해외 네오클라우드에서 임차한 GPU를 함께 활용하고 있다.
김장우 대표는 "망고부스트는 더이상 부품회사가 아닌 고객들에게 바로 가는 시스템 회사로서 다양한 전세계 부품회사가 찾아오는 기업이 될 것"이라며 "망고 인퍼런스를 통해 '서비스로 승부하는 회사'라는 것을 증명할 것"이라고 말했다.
/최효경 기자([email protected])
--comment--
첫 번째 댓글을 작성해 보세요.
댓글 바로가기